 IntelliSchreiber
Standardabweichung des Mittelwerts einfach erklärt
Du hast gerade eine Tabelle offen, ein paar Zahlen in Zellen eingetippt, und fragst dich, ob der Durchschnitt, den du daraus bekommst, wirklich belastbar ist. Genau an dieser Stelle taucht die Standardabweichung des Mittelwerts auf, oft auch Standardfehler des Mittelwerts genannt. Sie sagt nicht, wie stark einzelne Werte streuen, sondern wie sicher dein berechneter Mittelwert als Schätzung ist.
Einführung in den Standardfehler
In einem Psychologieexperiment misst du zum Beispiel Reaktionszeiten. Der Mittelwert wirkt auf den ersten Blick klar, aber eine einzelne Stichprobe ist immer nur ein Ausschnitt aus einer größeren Wirklichkeit. Wenn du dieselbe Untersuchung noch einmal mit anderen Teilnehmenden durchführst, wird der Mittelwert wieder leicht anders ausfallen.
Genau diese Unsicherheit steckt in der Standardabweichung des Mittelwerts. Sie hilft dir einzuschätzen, wie stark sich Mittelwerte aus wiederholten Stichproben typischerweise unterscheiden würden. Je kleiner der Wert, desto präziser ist deine Schätzung.
Ein Mittelwert ohne Streuungsmaß ist wie ein Zielwert ohne Trefferkreis. Erst der Standardfehler zeigt, wie eng oder weit deine Schätzung um den wahren Wert liegt.
Für Studierende ist das wichtig, weil viele Entscheidungen davon abhängen. Ist ein Effekt nur Zufall, oder steckt mehr dahinter? Ist eine Stichprobe groß genug, um eine Aussage zu tragen? Der Standardfehler liefert dafür keine endgültige Antwort, aber er gibt die Richtung vor.
Herleitung aus der Varianz
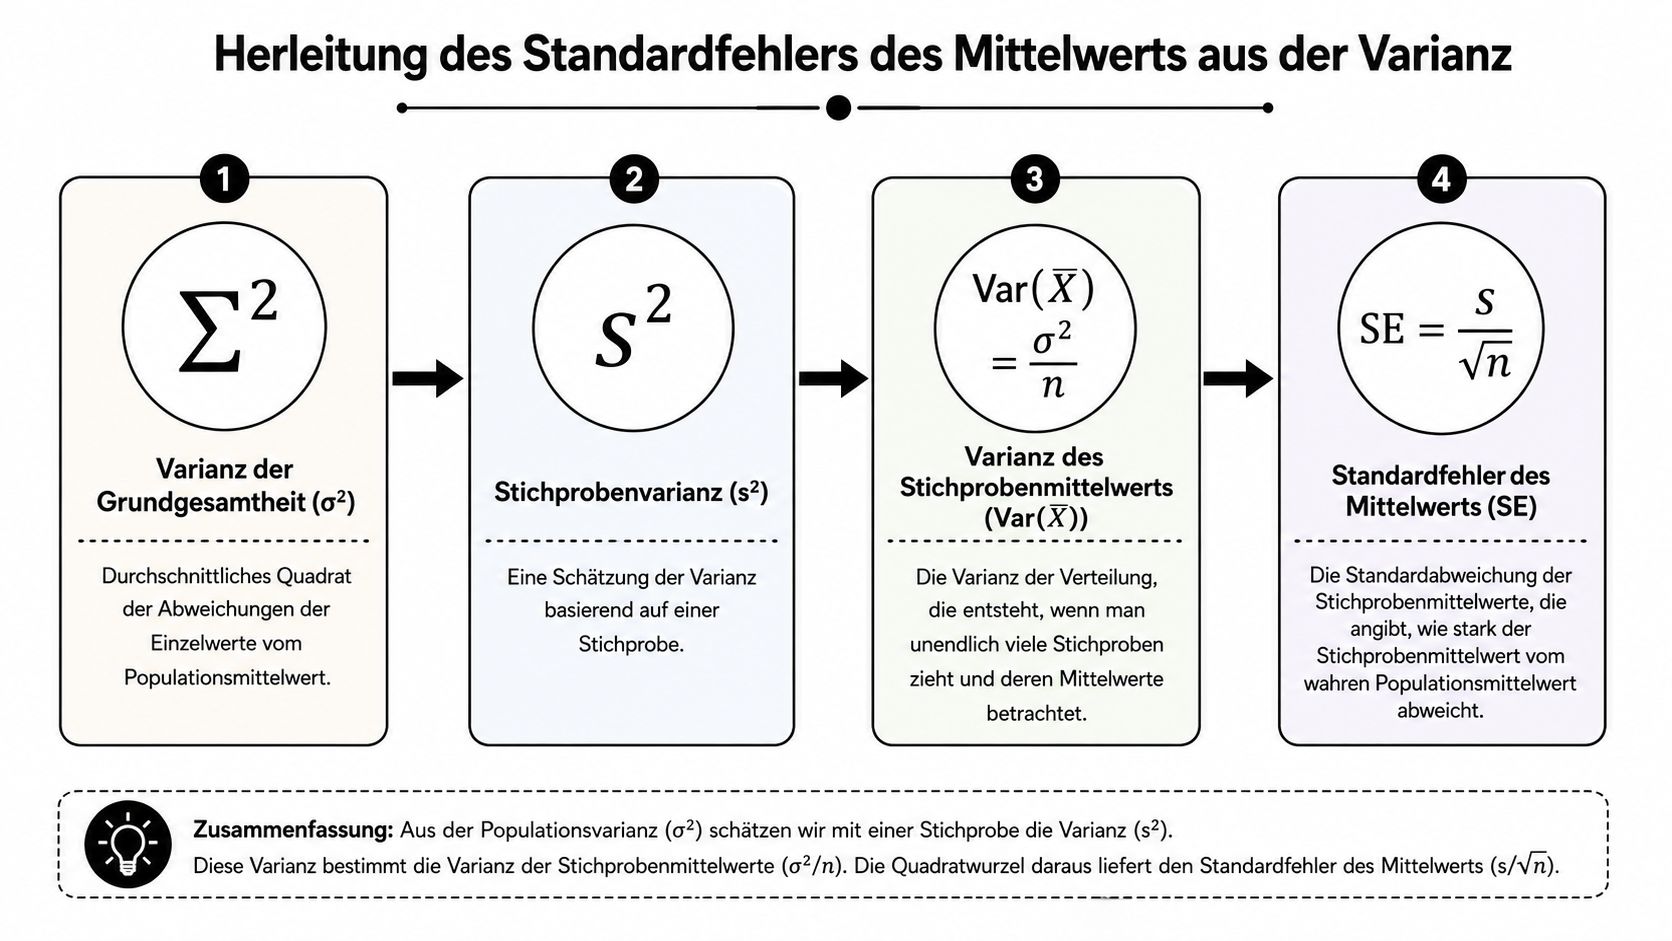
Die Herleitung ist weniger kompliziert, als sie zuerst klingt. Denk an Varianz als ein Maß dafür, wie weit Werte im Schnitt vom Mittelwert entfernt liegen, nur eben nicht direkt, sondern über quadrierte Abweichungen. Dadurch werden positive und negative Abstände nicht gegeneinander aufgehoben.
Die Grundidee lautet: Wenn viele Werte um einen Mittelwert streuen, dann streuen auch die möglichen Stichprobenmittelwerte um den wahren Mittelwert. Diese Streuung der Mittelwerte ist genau das, was der Standardfehler beschreibt.
Vom Quadrat zur Wurzel
Wenn du die Varianz einer Grundgesamtheit als σ² schreibst, dann ist die Streuung in denselben Einheiten wie die gemessene Größe erst nach der Wurzel sichtbar. Deshalb wird aus der Varianz wieder die Standardabweichung σ. Die Quadratwurzel bringt dich also zurück von „quadratischen Einheiten“ zu den ursprünglichen Einheiten deiner Daten.
Für den Mittelwert kommt dann der nächste Schritt: Die Streuung der Mittelwerte wird kleiner, wenn die Stichprobe wächst. Mathematisch taucht deshalb der Stichprobenumfang n im Nenner auf. Die gebräuchliche Form lautet SE = s / √n oder, wenn du mit der Populationsvarianz denkst, SE = √(σ² / n).
Warum der Umfang so viel ausmacht
Teilst du die gleiche Grundgesamtheit in mehr Beobachtungen auf, dann glättet sich das Zufällige stärker aus. Das ist wie bei einem Foto: Ein einzelner unscharfer Pixel sagt wenig, viele Pixel zusammen ergeben ein klareres Bild. Der Standardfehler nimmt deshalb mit wachsendem n ab, aber nicht linear, sondern über die Quadratwurzel.
Wenn du die Formel sauber im Kopf behalten willst, hilft dieser Merksatz:
- Varianz beschreibt die Streuung einzelner Werte.
- Standardabweichung macht diese Streuung wieder lesbar.
- Standardfehler misst die Unsicherheit des Mittelwerts.
Unterschied zur Stichprobenstandardabweichung
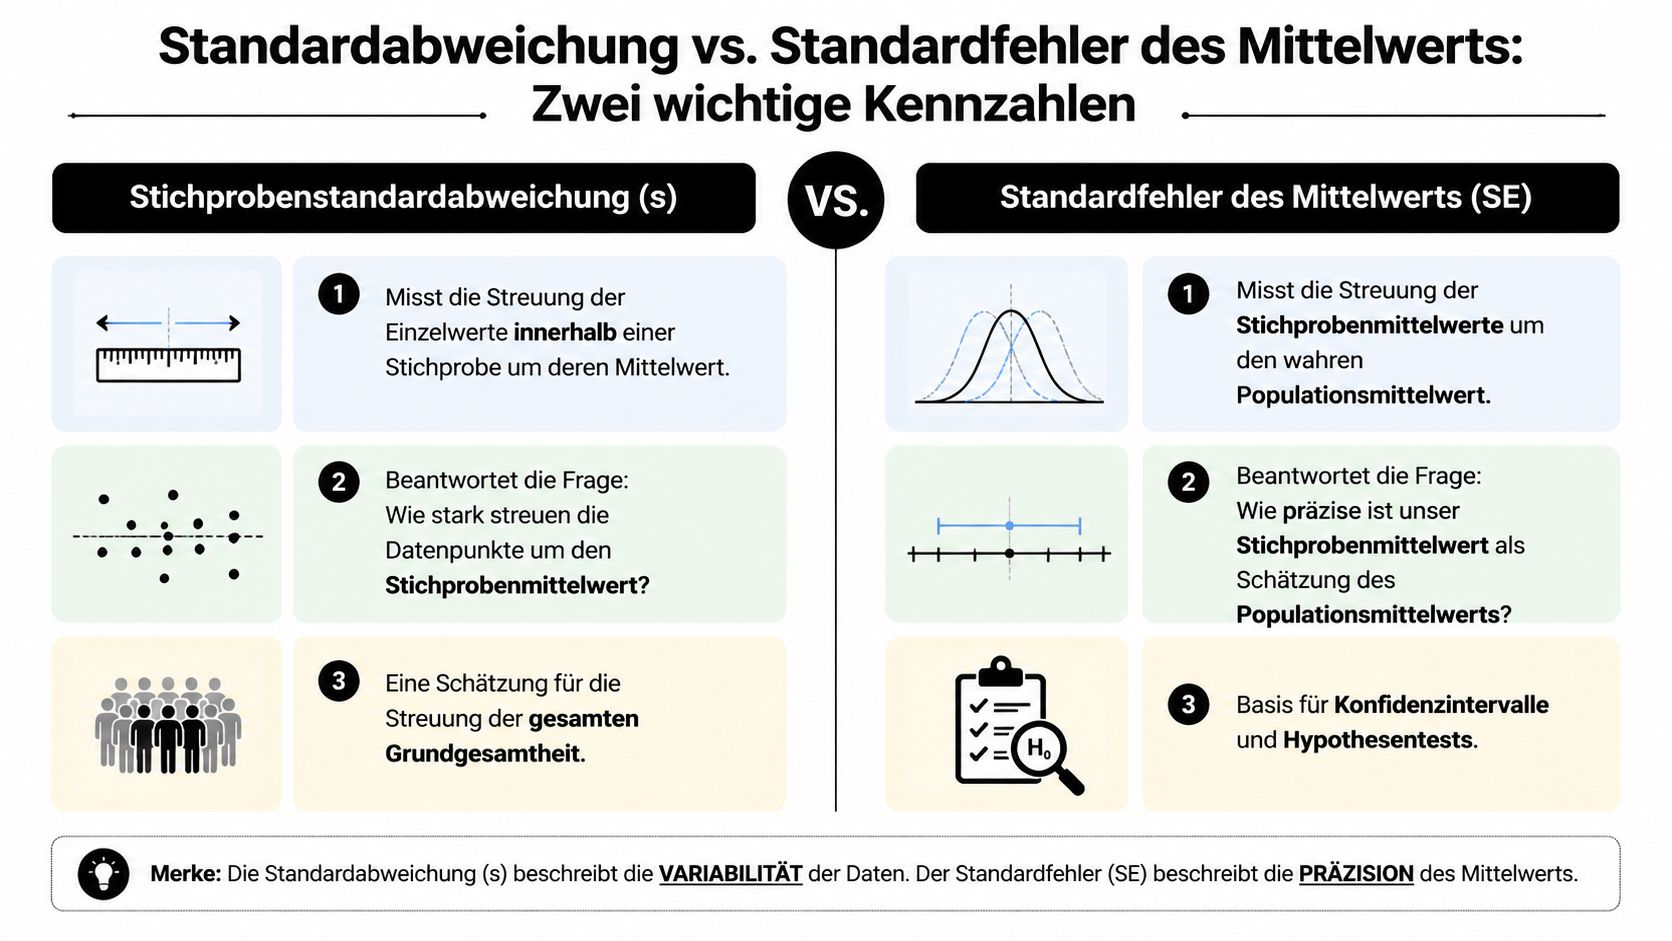
Die beiden Kennzahlen sehen ähnlich aus und werden im Alltag ständig verwechselt. Trotzdem beantworten sie verschiedene Fragen. Die Stichprobenstandardabweichung beschreibt, wie stark die einzelnen Beobachtungen innerhalb einer Stichprobe streuen. Der Standardfehler beschreibt, wie präzise der Mittelwert dieser Stichprobe ist.
Zwei Fragen, zwei Antworten
Wenn du wissen willst, ob Teilnehmende in ihrer Leistung sehr unterschiedlich sind, schaust du auf die Standardabweichung. Wenn du wissen willst, wie verlässlich der Mittelwert als Schätzer ist, schaust du auf den Standardfehler. Das ist der Kernunterschied.
Man kann es sich wie eine Klasse mit Prüfungsnoten vorstellen. Die Standardabweichung sagt dir, wie weit die Noten der Studierenden auseinanderliegen. Der Standardfehler sagt dir, wie sicher der Klassendurchschnitt als Schätzung für das Leistungsniveau dieser Gruppe ist.
Warum diese Verwechslung so häufig ist
Beide Werte hängen mit Streuung zusammen, aber auf unterschiedlichen Ebenen. Die Standardabweichung gehört zu den Rohdaten. Der Standardfehler gehört zum Mittelwert und damit zur Schätzung. Wer beides gleichsetzt, zieht schnell falsche Schlüsse, vor allem in Berichten, Abstracts oder Ergebnisabschnitten.
Praktische Regel: Wenn du über einzelne Personen, Messwerte oder Fälle sprichst, ist meist die Standardabweichung gemeint. Wenn du über die Präzision eines Mittelwerts sprichst, brauchst du den Standardfehler.
Einfluss der Stichprobengröße
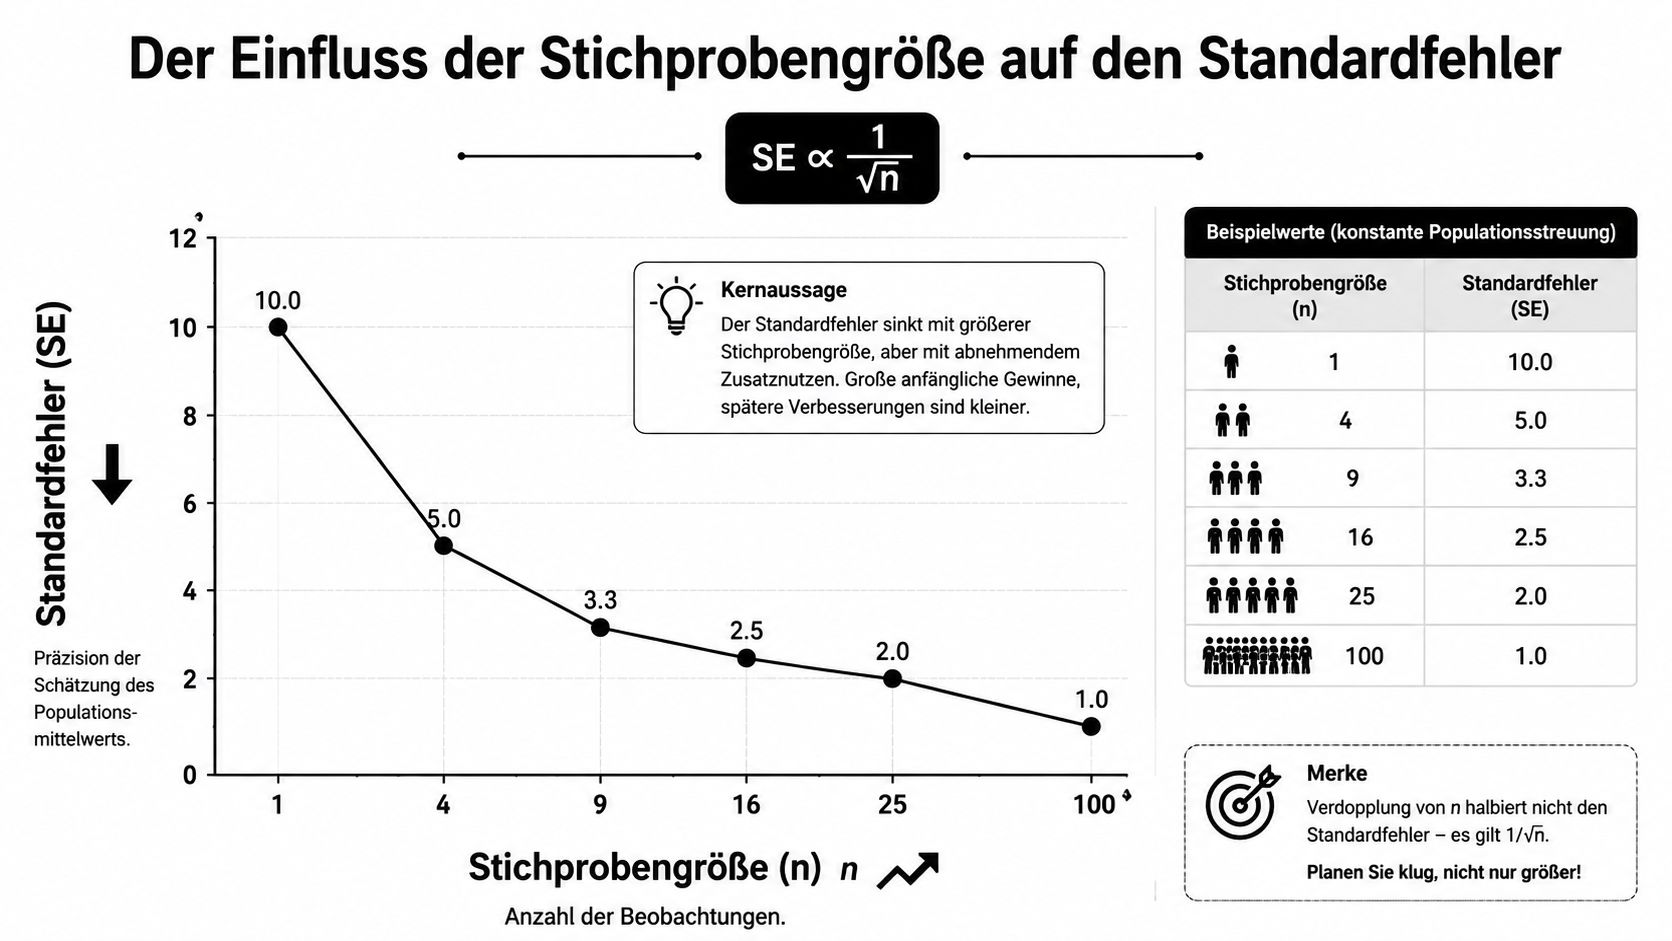
Der Stichprobenumfang wirkt direkt auf den Standardfehler, weil im Nenner die Wurzel aus n steht. Mehr Daten bedeuten also mehr Präzision, aber mit abnehmendem Zusatznutzen. Der erste Sprung von sehr kleiner zu etwas größerer Stichprobe bringt oft viel, spätere Vergrößerungen weniger.
Das Muster hinter der Formel
Die Beziehung SE ∝ 1/√n bedeutet, dass der Standardfehler mit wachsendem n sinkt. Verdoppelst du die Stichprobe, halbiert sich der Standardfehler nicht. Dafür müsstest du viel stärker vergrößern, weil die Wurzel bremst.
Das ist in der Praxis wichtig. Wer eine sehr kleine Stichprobe hat, arbeitet mit unscharfen Schätzungen. Wer eine größere Stichprobe plant, gewinnt an Stabilität, aber irgendwann wird jeder zusätzliche Datensatz nur noch ein kleines Stück genauer.
Ein Alltagsbild
Stell dir vor, du misst das Gewicht eines Pakets mit einer wackeligen Waage. Ein einzelner Messwert schwankt leicht. Wenn du mehrmals misst und mitteln darfst, wird das Ergebnis ruhiger. Der Standardfehler sagt dir, wie stark diese gemittelten Werte noch schwanken würden.
Die zentrale Einsicht ist simpel: Mehr Beobachtungen machen den Mittelwert verlässlicher. Aber mehr heißt nicht unendlich besser. Die Kosten, der Aufwand und die verfügbare Zeit setzen in realen Projekten Grenzen.
Beispielrechnungen zum Standardfehler
Nimm eine kleine Gruppe von Testpunktzahlen: 72, 68, 75, 70 und 65. Der erste Schritt ist der Mittelwert. Addiere alle Werte und teile durch die Anzahl der Werte. So bekommst du den zentralen Schätzwert der Gruppe.
Dann schaust du auf die Abweichungen jedes Werts vom Mittelwert. Diese Abweichungen werden quadriert, damit negative und positive Werte sich nicht aufheben. Aus diesen quadrierten Abständen berechnest du die Stichprobenvarianz und daraus die Stichprobenstandardabweichung.
Rechenweg in einfachen Schritten
Mittelwert bilden
Addiere alle Punktzahlen und teile durch die Anzahl der Werte.Abweichungen bestimmen
Ziehe von jedem Wert den Mittelwert ab.Abweichungen quadrieren
So wird aus jeder Differenz ein positiver Beitrag zur Streuung.Varianz und Standardabweichung berechnen
Die Varianz fasst die quadrierten Abweichungen zusammen, die Standardabweichung macht daraus wieder eine anschauliche Größe.Standardfehler ableiten
Teile die Standardabweichung durch die Wurzel aus der Stichprobengröße.
Wenn du beim Rechnen ins Stocken gerätst, prüfe zuerst immer drei Dinge, den Mittelwert, die Stichprobengröße und ob du wirklich durch die Wurzel von n teilst.
Für einen sauberen Workflow in Hausarbeiten oder Projekten kann dir auch eine strukturierte Vorgehensweise helfen, wie sie in diesem Workflow-Artikel zur Statistik in der Hausarbeit beschrieben wird.
Anwendung in Konfidenzintervallen und Hypothesentests
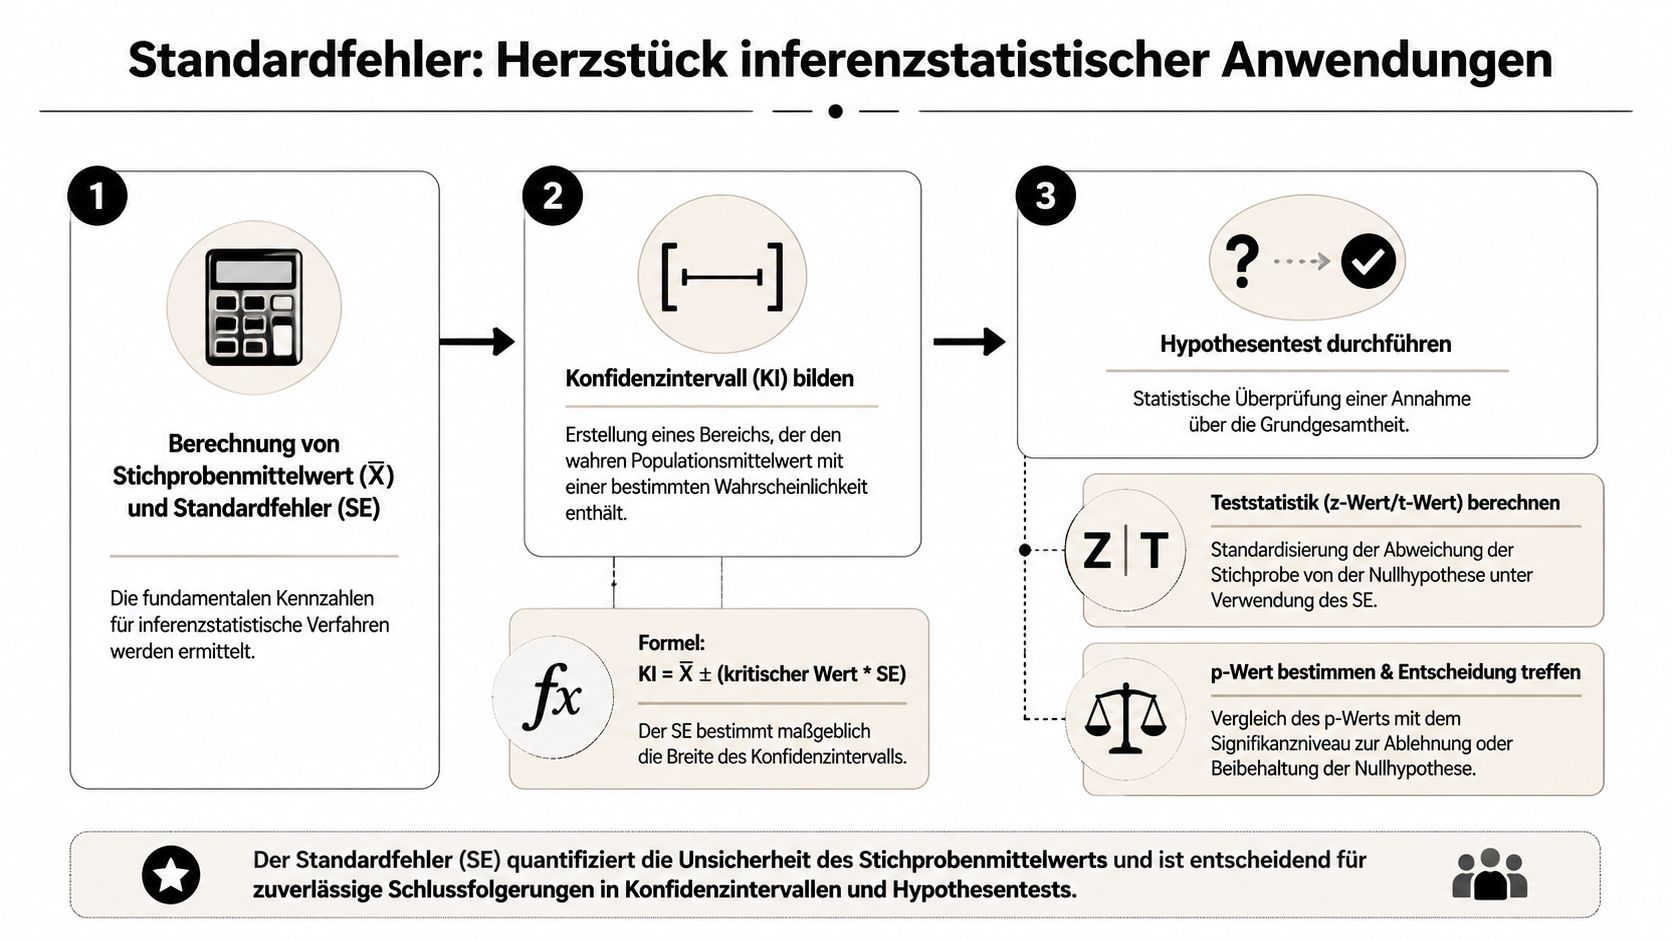
Der Standardfehler ist nicht nur eine Rechengröße, sondern die Brücke zu vielen inferenzstatistischen Verfahren. Sobald du aus einer Stichprobe auf eine Grundgesamtheit schließen willst, spielt er mit. Er steckt in Konfidenzintervallen genauso wie in Teststatistiken.
Konfidenzintervalle verstehen
Ein Konfidenzintervall legt einen Bereich um den Stichprobenmittelwert. Die Breite dieses Bereichs hängt direkt vom Standardfehler ab. Je kleiner der Standardfehler, desto enger das Intervall und desto präziser die Schätzung.
Die Grundidee ist intuitiv. Wenn dein Mittelwert mit wenig Unsicherheit geschätzt wurde, brauchst du keinen breiten Sicherheitskorridor. Wenn die Stichprobe unruhig ist, wird der Korridor breiter. Darum ist der Standardfehler für die Interpretation von Ergebnissen so wichtig.
Hypothesentests einordnen
Auch bei t-Tests und z-Tests wird die beobachtete Abweichung durch den Standardfehler standardisiert. Dadurch wird aus einer rohen Differenz eine vergleichbare Teststatistik. Erst diese Normierung macht Aussagen über ungewöhnliche oder erwartbare Abweichungen möglich.
Wer sich tiefer mit dem t-Test beschäftigen will, findet eine ausführliche Einführung in diesem Leitfaden zum t-Test.
Was der Standardfehler dabei leistet
Er liefert die Skala, auf der Zufallseinflüsse sichtbar werden. Ohne ihn wäre kaum zu beurteilen, ob ein Mittelwert wirklich auffällig ist oder nur zufällig verschoben. Genau deshalb taucht der Standardfehler in so vielen Auswertungen als stille, aber zentrale Größe auf.
Berechnung in Excel R und Python
In der Praxis willst du die Standardabweichung des Mittelwerts oft schnell in einem Tool berechnen, ohne den Rechenweg jedes Mal neu aufzubauen. Das geht in Excel, R und Python mit wenigen Schritten. Wichtig ist nur, dass du die richtige Streuungsgröße nimmst und sie korrekt mit der Stichprobengröße verknüpfst.
Excel
Wenn deine Daten in A2:A21 stehen, kannst du zuerst die Stichprobenstandardabweichung berechnen und dann den Standardfehler ableiten. Die typische Formel lautet:
=STABW.S(A2:A21)/WURZEL(ANZAHL(A2:A21))
In manchen englischsprachigen Excel-Versionen heißt die Funktion STDEV.S und SQRT. Wenn du mit absoluten Zellbezügen arbeitest, bleibt die Formel sauber, falls du sie nach unten kopierst. Das ist nützlich, wenn du mehrere Gruppen nebeneinander auswertest.
R
In R ist der Weg kurz und direkt. Für einen Vektor x reicht:
sd(x) / sqrt(length(x))
Wenn du fehlende Werte enthalten hast, musst du sauber mit na.rm = TRUE arbeiten, sonst kommt ein fehlerhaftes Ergebnis heraus. R ist hier angenehm, weil du denselben Ausdruck in Skripten, Reports und Notebooks wiederverwenden kannst.
Python
Mit NumPy sieht es ähnlich aus:
import numpy as npx = np.array([72, 68, 75, 70, 65])se = np.std(x, ddof=1) / np.sqrt(len(x))
Der Parameter ddof=1 ist wichtig, weil du die Stichprobenstandardabweichung statt der Populationsstandardabweichung brauchst. Genau an dieser Stelle passieren in der Praxis viele Fehler.
Typische Fallstricke und Fazit
Der häufigste Fehler ist die Verwechslung von Standardabweichung und Standardfehler. Ein zweiter Klassiker ist die falsche Formel, etwa wenn die Stichprobe nicht unter der Wurzel auftaucht oder die falsche Streuungsgröße verwendet wird. Auch das blinde Übertragen eines Mittelwerts auf die Grundgesamtheit ohne Blick auf die Unsicherheit führt schnell in die Irre.
Wer sauber interpretieren will, prüft drei Dinge. Erstens, misst der Wert die Streuung der Einzelwerte oder die Präzision des Mittelwerts? Zweitens, wurde die richtige Stichprobengröße eingesetzt? Drittens, ist die Aussage passend zur Fragestellung formuliert?
Für die methodische Einordnung deiner Ergebnisse lohnt sich auch ein Blick auf Reliabilität und Validität in Abschlussarbeiten. Gerade bei kleinen Stichproben hilft eine klare Kommunikation mehr als scheinbare Präzision.
Der Standardfehler des Mittelwerts ist kein Nebenthema. Er entscheidet mit darüber, wie vorsichtig oder selbstbewusst du Ergebnisse lesen darfst. Wenn du ihn korrekt berechnest und sauber von der Standardabweichung trennst, wird deine Statistik sofort verständlicher und deine Interpretation deutlich belastbarer.
Wenn du statistische Begriffe in deiner Hausarbeit oder Abschlussarbeit sicher erklären, berechnen und korrekt einbauen willst, nutze IntelliSchreiber als Unterstützung für strukturierte, zitierfähige Texte mit klarem Aufbau und verlässlicher Arbeitsersparnis.